구글 리서치가 다변량 시계열 예측에 특화된 인공지능(AI) 모델 TimesFM-3를 2026년 8월 31일 공식 연구 블로그에서 공개했다. 이 모델은 3억3000만 개의 파라미터를 갖고 있으며, 실제·합성 데이터를 합쳐 1조 개가 넘는 시계열 시점으로 사전학습됐다. 하나의 시계열만 보는 기존 버전과 달리 여러 목표 변수와 보조 변수를 함께 처리하고, 별도 과제별 미세조정 없이 예측하는 제로샷 방식을 지원한다.
TimesFM-3는 여러 목표 시계열뿐 아니라 과거에만 알려진 보조 변수와 미래 일정처럼 미리 알 수 있는 동적 변수도 입력받는다. 구글은 아이스크림 매출 예시에서 관련 상품 판매, 방문량, 날씨, 판촉 일정을 함께 반영하는 방식을 설명했다. 판촉일에 약 20%의 매출 상승을 예상한 결과는 모델 동작을 보여 주는 예시이며, 특정 기업의 실제 매출이나 보장된 성과를 뜻하지 않는다.
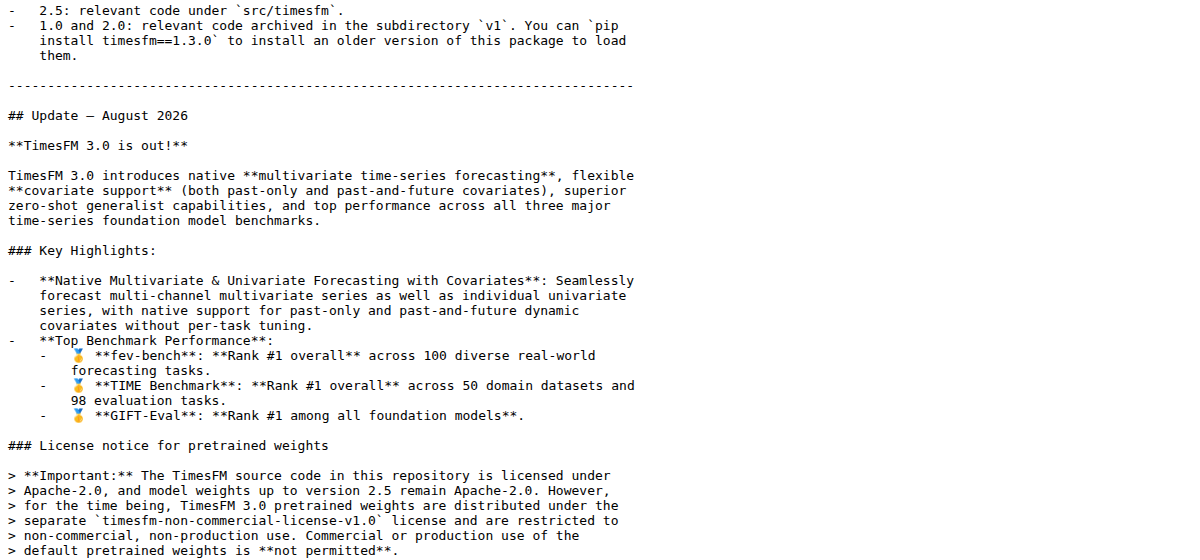
모델은 연속된 데이터를 32개 시점 단위의 패치로 묶은 뒤, 시간축에는 과거 정보만 보도록 하는 인과적 어텐션을 적용하고 변수축에는 전체 어텐션을 적용한다. 이를 통해 변수 사이의 의존관계를 학습하되 미래 정보가 과거 예측에 섞이지 않도록 했다. 이전 버전처럼 예측 구간을 패치별로 반복 생성하지 않고 전체 구간을 한 번에 계산한다. 구글이 공개한 GIFT-Eval, FEV-Bench, TIME 평가에서는 점 예측과 확률 예측의 평균 순위가 비교 대상 사전학습 모델 가운데 가장 높았다.
공식 저장소 README에 따르면 TimesFM 소스코드는 Apache-2.0으로 공개됐지만 TimesFM 3.0 사전학습 가중치는 별도의 비상업·비프로덕션 라이선스를 적용한다. 따라서 공개 코드를 상업적으로 이용할 수 있다는 사실이 3.0 기본 가중치의 상업 이용까지 허용한다는 뜻은 아니다. 모델 체크포인트는 허깅페이스에서 제공되며, 구글은 BigQuery 통합도 수주 안에 제공할 계획이라고 밝혔다.
기업이 TimesFM-3를 검토할 때는 모델의 공개 벤치마크 순위뿐 아니라 자사 데이터의 변수 구성, 예측 구간, 결측치와 분포 변화에 맞춰 성능을 다시 확인해야 한다. 판매량·방문량·판촉 일정처럼 서로 연결된 신호를 함께 다룬다는 점은 유통, 제조, 관측, 의료 등 다변량 예측 문제에 유용할 수 있다. 다만 실제 배포 여부는 데이터별 검증 결과와 가중치 라이선스, 향후 제공될 상용 경로를 함께 확인한 뒤 결정해야 한다.
저작권자 © STORIUM 무단전재 및 재배포 금지